-
标梵小秘书
已经收到您的留言,我们马上联系您!

400-777-2806
-
在线咨询
-
微信咨询
标梵小秘书
已经收到您的留言,我们马上联系您!
400-777-2806
服务器在我们手上 ,真出事的时候「我们已经通知客户了」这句话, 没有任何意义 。
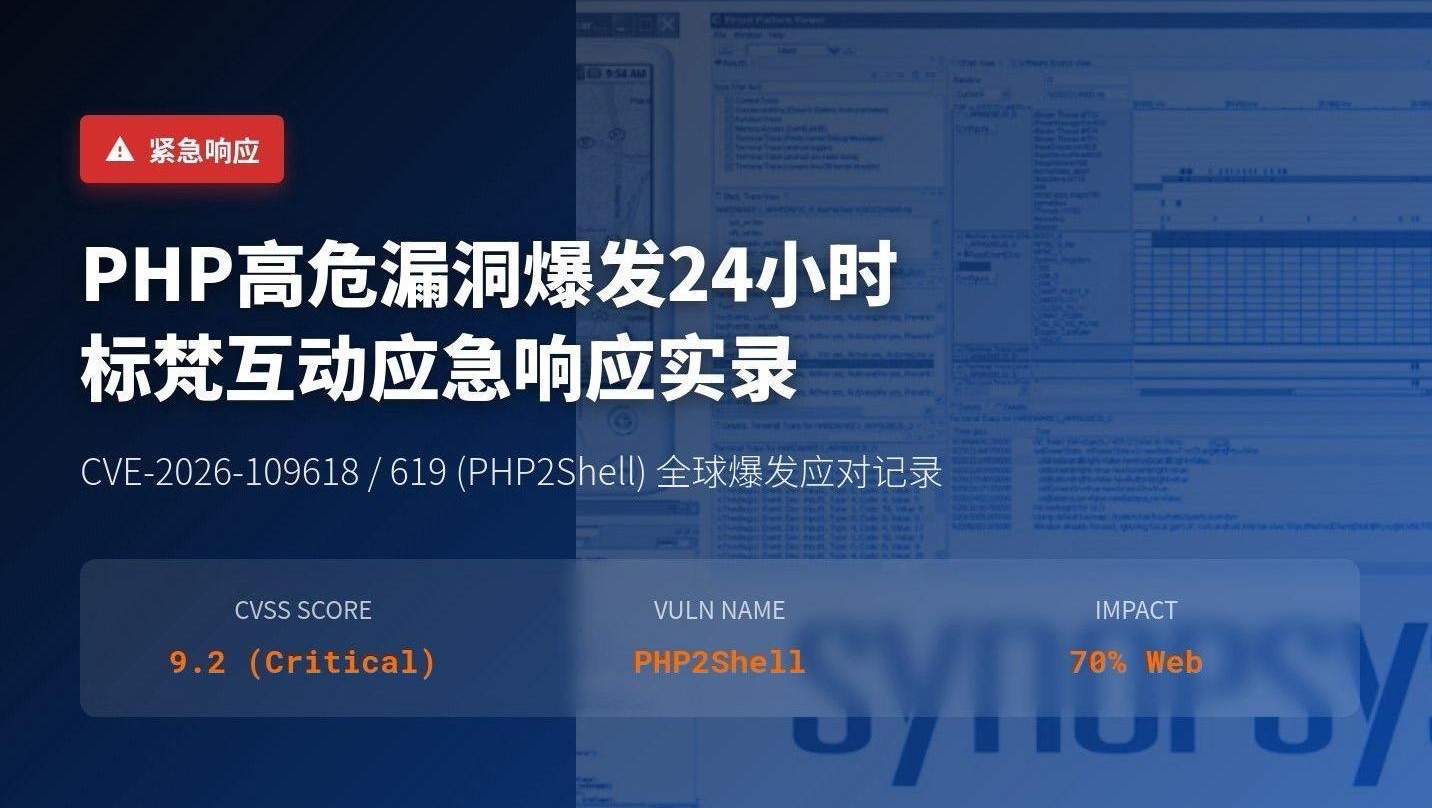
10月21日,PHP官方发了一次紧急更新,修掉两个漏洞:CVE-2026-109618、CVE-2026-109619。安全圈给它们起了个很直白的名字,PHP2Shell。 一个HTTP请求进去,一个shell出来。
CVSS评分 9.2 。这个分数放在漏洞里,基本等于「别犹豫了」。
真正麻烦的地方在于,它不需要你有账号,不需要你开放后台,也不需要你的网站刚好有个上传功能。请求还没进到业务代码, 在PHP处理请求那一层就已经出事 。PHP-FPM、Apache的mod_php、php-cgi、LiteSpeed,这些跑PHP的方式,全在名单里。
漏洞细节和利用工具很快就在社区公开了。亚马逊后来披露, 补丁正式发布前四天 ,就已经有人在尝试利用。
全球七成左右的网站,后端跑的是PHP。 从企业官网、电商平台到政务系统,都在射程之内。
之后几天的事很多人都看到了:德国关掉了一批联邦站点,法国、比利时、荷兰的公共服务陆续下线避险。有些地方的做法很干脆, 先拔网线,再讨论 。
对我们来说,这不是一条新闻。
我们的主业是给企业建官网、做长期运维,PHP是绕不开的技术栈。客户把站交过来,服务器在我们手上。真出事的时候,「我们已经通知客户了」这句话没有任何意义。
那天下午看到消息,冒出来的第一个问题不是「我们受不受影响」,是 「我们到底有多少个PHP在跑」 。
这个问题,我们花了 将近两个小时 才答上来。
下面是这24小时的记录
01 别急着升级,先把家底数清楚
漏洞通告出来,最自然的反应是: 找到修复版本,升级,收工 。
真做过运维的都知道,这只在一种前提下成立—— 你清楚地知道每个站在跑什么 。
我们不知道。
不是完全不知道。站点台账我们有,域名、备案主体、责任人、服务器IP,一条不少。但台账不记这个 :站的PHP是谁装的、从哪装的、装在哪一层。
一个站点不等于一个PHP。 宿主机上可能装了一个,容器里跑的是另一个,面板自己带了一个,客户三年前找人编译的又是一个。还有测试环境、预发布环境、CDN回源的源站。它们都连着公网,都可能被扫到。
所以第一个小时,我们 没动任何一台生产机器 。
我们把所有在管的机器拉成一张表,一台一台核: php -v 、 php-fpm -v 、 docker ps 、面板里显示的版本、进程实际指向的路径。核完就往在线表格里填,谁核完谁打勾。
这张表后来成了那两天的 作战地图 :哪台机器、什么版本、怎么部署的、归谁管、能不能停。
!踩坑提示 🕳
有个坑就是这一步查出来的。某台机器命令行敲 php -v ,显示8.3,但网站实际走的是另一个路径下的FPM,版本比它低一截。这种站,只在命令行里升级,等于没升。
02 能关的门先关上
表格填到一半,我们意识到另一件事: 升级需要时间,攻击不需要。
所以第二件事不是打补丁, 是做减法 。
网关层先加规则:异常的multipart请求体直接拒,请求头过大、字段名嵌套过深的也拒。这两个漏洞公开的利用路径都走multipart POST。这些规则拦不住真正的攻击者,但能把大规模扫描挡在门外,也能让日志里浮出那些探头的人。
然后关掉一批「平时懒得关」的东西: session.upload_progress (大部分站根本不做上传进度条,而官方把它列为已确认的触发路径之一)、phpinfo页面、测试域名、几个入口不严的后台。这些东西平时是风险, 那天就是邀请函 。
数据库、Redis、FPM的9000端口,一律收回内网,只走白名单 。
💡 这些动作有个前提得说清楚:它们修不好漏洞。官方讲得很直白,不存在能够完整消除这两个漏洞风险的通用配置方案,升级到修复版本才是唯一解。
「补丁是解药,这些配置是止血带。止血带止不住血,但能让你活到救护车来。」
03 升级不按「重要」排队,按「能不能停」排队
第一版排期是按站点等级来的:A类客户先升,B类跟上。 排到一半发现不对 。
A类里有个客户的站正在做大促, 白天停十分钟就是钱 。B类里有个外贸站,客户全在欧洲,我们的深夜正好撞上他们的白天,晚上反而是高峰。
等级是我们内部的分类,停机窗口是客户的生意。这两件事对不上。
于是重排: 按「这个站什么时候能停」排,不按「这个站多重要」排 。能停的,当天夜里升完;不能停的,靠02那批网关规则先顶着,等它自己的窗口。
老版本是另一回事。8.1及更早的版本官方已经停止维护,这次只提供源码补丁,得自己编译。有个跑了七年的站,PHP 7.4,一套老框架,扩展全是当年编译的。我们把补丁编进去,重启,一个扩展加载失败,站点白屏 。
回滚,十分钟内恢复 。
然后换方案:单独一台机器把它隔离出来跑,前面挂网关白名单,只放它自己的业务IP。这个站在整个漏洞期没停过,代价是我们确实 没能在24小时内把它升到官方版本 。
这里说一句不讨喜的话。这种事件里,「24小时全量闭环」喊出来是要负责任的。我们的真实情况是:绝大多数站点在24小时内升完并验证过,剩下几台,我们选的是隔离,不是硬升。硬升下去白屏一次,客户的损失比漏洞本身来得更直接。
04 收尾比开头难:验证不看版本号,看进程
升级完成不等于修好。这话听着像废话, 坑就在这儿 。
第一种,版本升了,FPM没重启,跑的还是老进程。第二种,宿主机升了,容器里的镜像没重建,容器里还是老二进制。第三种,那套PHP是客户自己装的,不在我们的包管理里, yum update根本碰不到它。
所以验证走三步:
1、看进程实际加载的二进制路径和版本
2、重启之后再核一遍
3、拿构造好的请求在测试环境回放,确认打不进去
生产环境不做攻击测试, 这是纪律 。
告知函也换了写法。这种函最容易写成「我们已全面完成处置,请放心」。我们这份是每户一张, 写清楚四件事 :你的站现在是什么版本、我们改了什么、还剩什么风险、下一次该在什么时候动。
多数客户是在收到函之后, 才知道外面出过这么大的事 。
有客户回邮件问:你们怎么知道我这台还在7.4?
因为那张表是我们自己一台台扫出来的,不是从台账上抄的
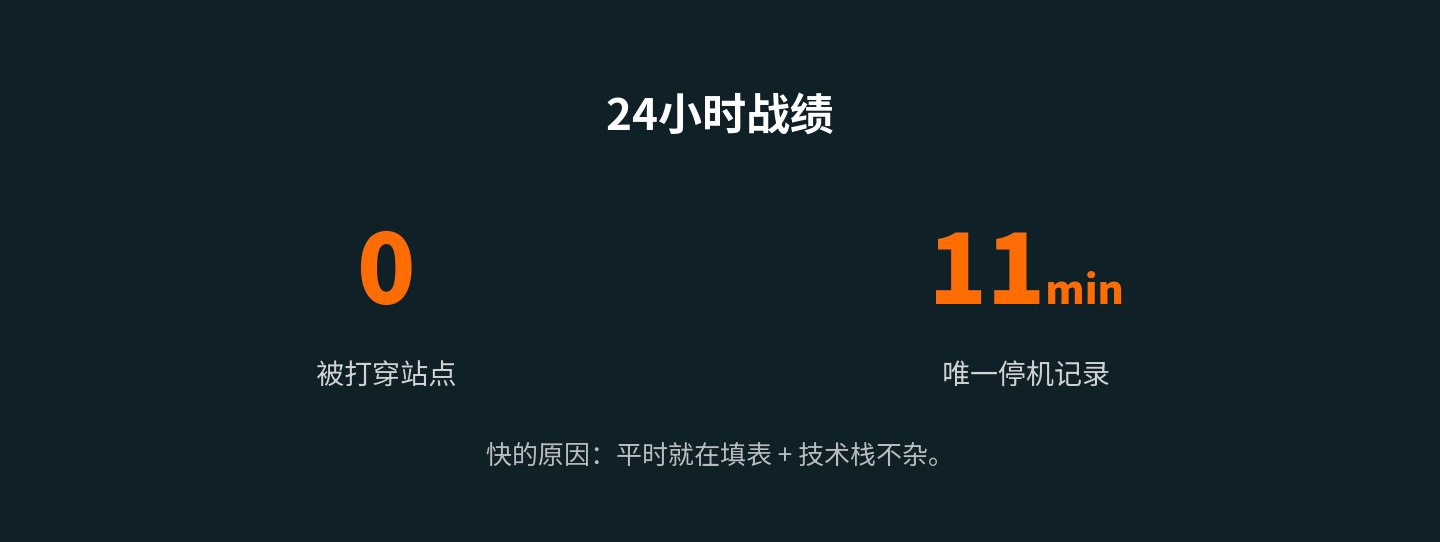
结果是, 在管站点没有一台被打穿 。有一台在升级窗口里多停了十一分钟,客户第二天才知道。这十一分钟我们记在复盘里, 没打算藏 。
05 快,快在哪
两个原因,都不新鲜。
那张表平时就在填,不是为了这次临时做的。哪台机器谁在管、什么版本、上次动是什么时候,这些平时看着没用的东西,那天省了我们两个小时。
技术栈没那么杂,给企业建站,最怕东拼西凑:三家供应商、四套系统、五个PHP版本。漏洞来了,连自己有多少台在裸奔都数不清。我们不接「只做页面、服务器客户自己找」的活,原因就在这儿—— 接管不了机器,就守不住站 。
06 如果你自己在管网站,今天可以做完三件事
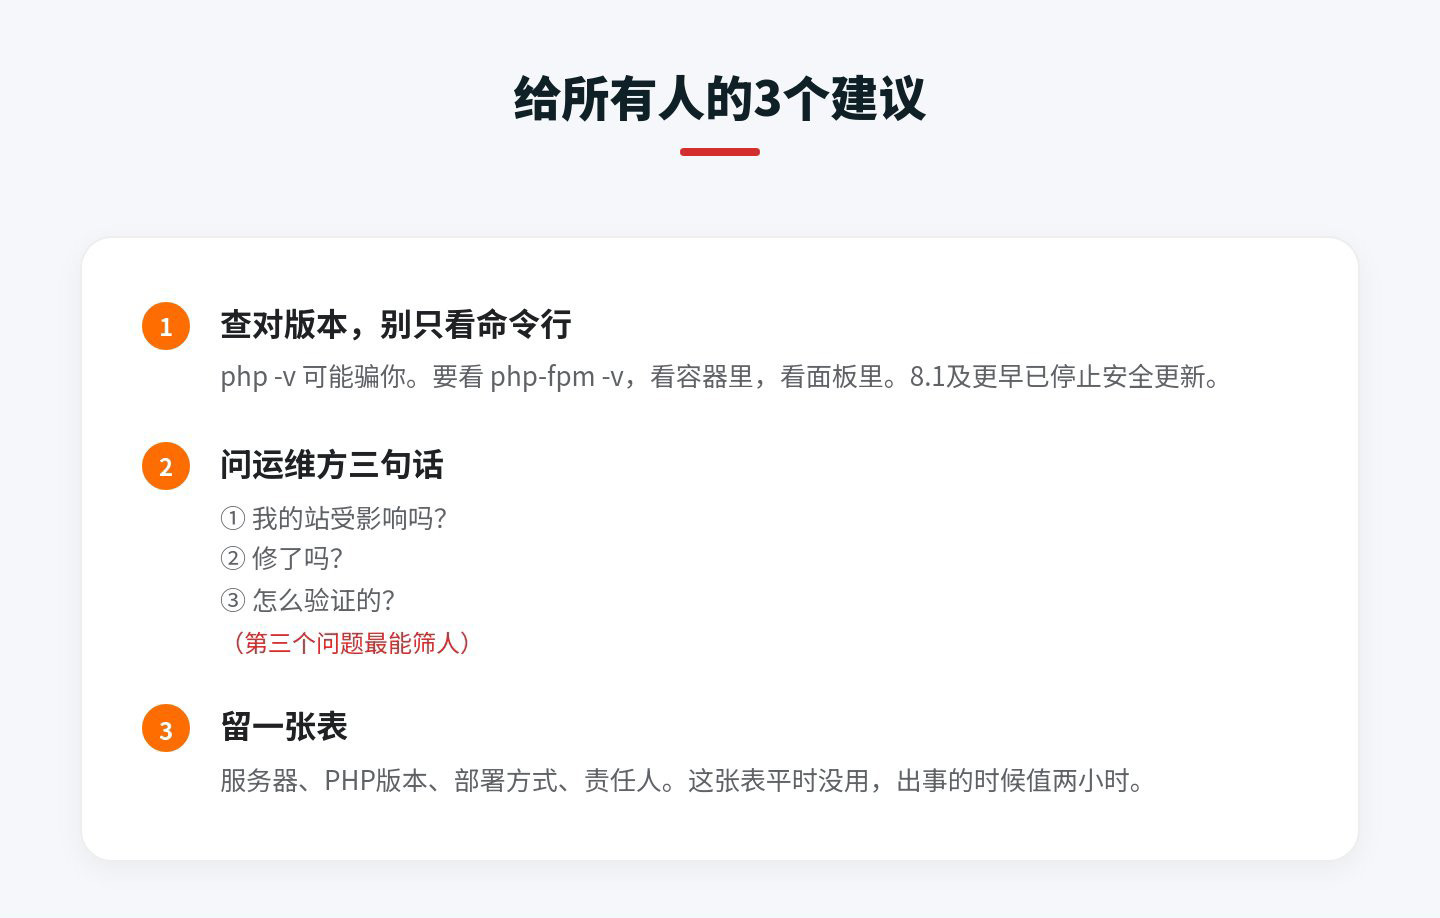
1、查版本,而且查对地方。php -v 只是命令行,网站跑的很可能是另一个二进制。看 php-fpm -v,看容器里,看面板里。8.1及更早的版本官方已停止安全更新,8.2的安全支持也到今年年底为止。停在8.1上的站,这次官方只给源码补丁,得自己编译。
2、问三句话。问你的建站方或者运维方:我的站受影响吗?修了吗?怎么验证的?第三个问题最能筛人。只答「升到最新版了」的,多半没验证过。
3、留一张表。服务器、PHP版本、部署方式、备案主体、责任人、能不能停。这张表平时没用,出事的时候值两个小时。
写在最后
24小时,在管站点没有一台被打穿。这句话我们敢说,是因为它背后有一张现扫的表、一次十分钟的回滚、一台多停了十一分钟的站,还有几个最终选择隔离而不是硬升的客户站点。
「安全这件事没有满分。能做的是让下一次来的时候,比上一次快一点。」
不确定自己的站有没有修干净,或者手上压根没有那张表,可以找我们。第一步就是把版本查清楚。
我是标梵互动,专注企业官网建设与长期运维。